Un OCR devuelve texto
Convierte los píxeles en caracteres. Lo que sale es una maraña de palabras y números sin saber qué es cada cosa: sirve para buscar dentro de un archivo, no para contabilizar.
Sube una foto, un escaneo o un PDF y recupera lo que pone. Si además el documento es una factura o un albarán, Dijit no se queda en el texto: saca el proveedor, las líneas, los impuestos y el total, y los deja en tu ERP.
Decide si la herramienta sirve para contabilizar o solo para archivar.
Convierte los píxeles en caracteres. Lo que sale es una maraña de palabras y números sin saber qué es cada cosa: sirve para buscar dentro de un archivo, no para contabilizar.
Interpreta: entiende que ese número de nueve cifras junto a una razón social es una identificación fiscal, y que esa cifra al pie es el total y no un número de página.
Por eso Dijit no necesita plantillas por proveedor: no le hace falta saber de antemano dónde imprime cada uno sus datos.
Reconocer, interpretar, validar y clasificar.
El OCR convierte la imagen en texto localizable.
La IA decide qué es cada dato: cuál es el emisor, cuál la fecha, cuál la base imponible.
Que base más impuestos sea el total, que las líneas sumen, y que el documento no esté duplicado.
Se asignan las cuentas contables con el histórico de la empresa y las reglas configuradas.
La precisión media de lectura y clasificación es del 99% sobre PDF original. En una foto depende de la imagen, y la diferencia entre un caso y otro es grande.
| Origen del documento | Qué esperar |
|---|---|
| PDF generado por el sistema del emisor | El texto ya está dentro del archivo. Se lee prácticamente exacto. |
| PDF escaneado | Requiere reconocimiento. Bueno con un escaneo limpio. |
| Fotografía | Sensible al encuadre, la iluminación y las sombras. |
| Ticket térmico o fotocopia degradada | El original ya ha perdido información: es donde más hay que corregir. |
La consecuencia práctica: cuando un documento se lee mal una y otra vez, antes de corregirlo conviene mirar cómo entra. Mejorar el origen resuelve más que corregir el resultado.
Merece la pena repetir una foto dudosa en el momento: corregirla después cuesta mucho más que volver a disparar. Y si el documento no cabe en una toma, se hacen varias y se agrupan como un solo documento.
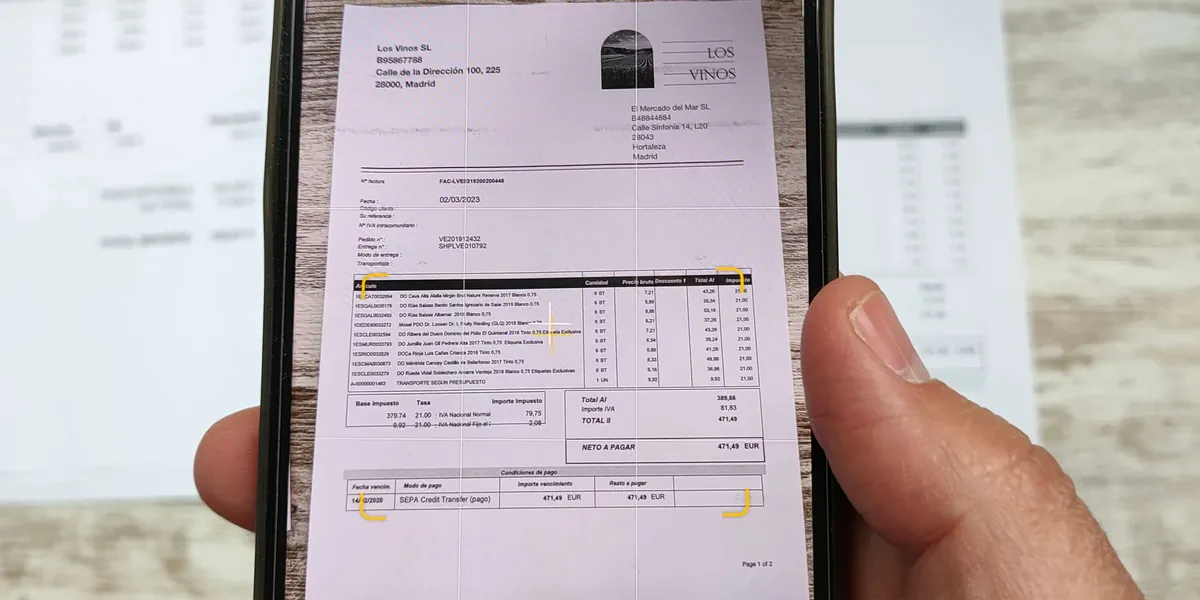
Si lo que fotografías son facturas o albaranes, el texto no es el final del trabajo.
Proveedor, CIF, fecha, líneas, base, impuestos y total, campo a campo.
Por conector directo o en Excel con la estructura que pidas. Las integraciones.
Propuesta según el histórico de la empresa, no elegida a mano cada vez.
Lo que no cuadra se marca, con el documento al lado.
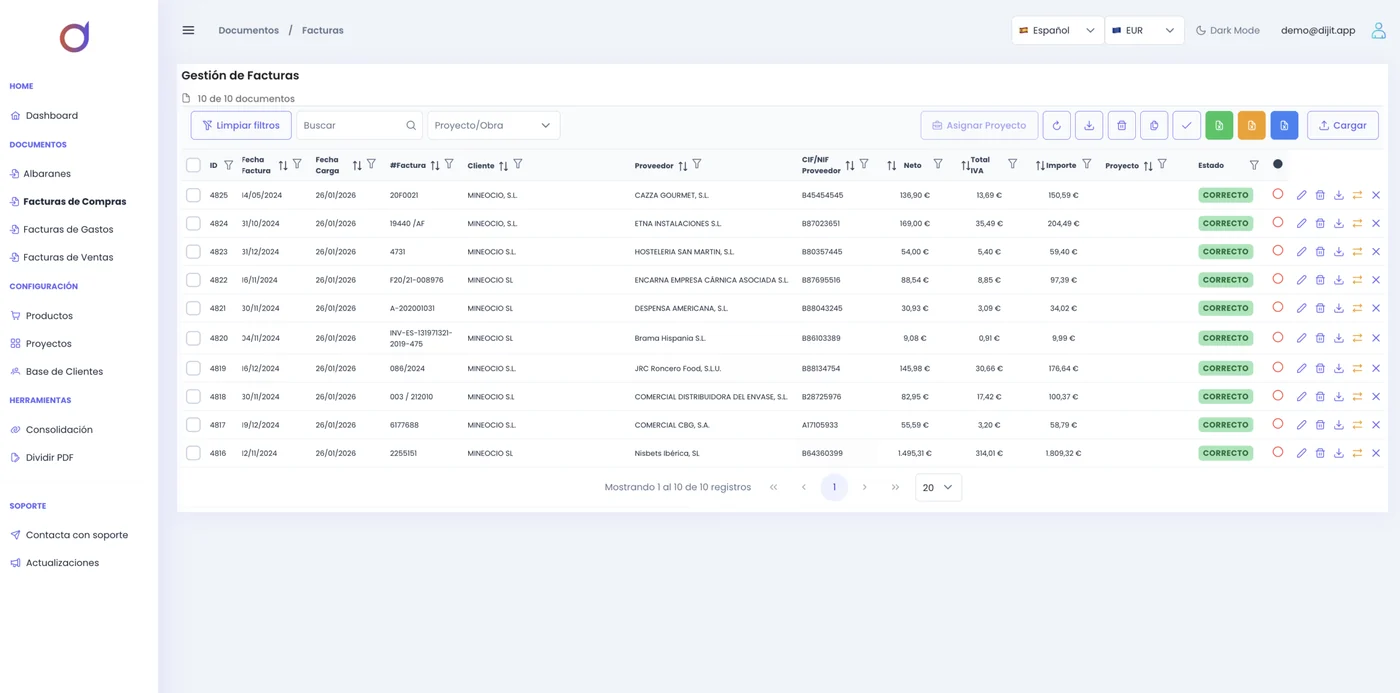
Todo lo que entra en una empresa por el lado de compras y de contabilidad, en imagen o en PDF.
Facturas recibidas, simplificadas, intracomunitarias, de importación con DUA, rectificativas y con retención. También tickets y notas de gasto.
Albaranes de recepción y de venta, facturas de transportista, órdenes de compra y hojas de transporte. Ver digitalizar albaranes.
Partes de trabajo y hojas de producción rellenados a mano. La precisión depende de la letra y de la foto, como en cualquier documento fotografiado.
Si tienes un documento que hoy no se lee, se entrena para ese caso: reglas de extracción y de validación propias, por empresa y por proveedor.
Conviene decirlo, porque ahorra tiempo a todos. Si lo que quieres es sacar el texto de la foto de un cartel, de un libro o de una pizarra, con el OCR del propio móvil o con cualquier herramienta gratuita tienes de sobra: lo que necesitas es el texto, y ahí se acaba el trabajo.
Dijit es para el documento que tiene que acabar en la contabilidad. La conversión a texto es el primer paso de cuatro, y los otros tres —interpretar, validar y clasificar— son los que te quitan el trabajo de encima. Si el documento no va a ningún ERP, te estamos cobrando por algo que no necesitas.
Y tampoco hacemos facturación de ventas: Dijit cubre compras y contabilidad, es decir el IVA soportado.
Los formatos habituales de imagen y PDF, con un límite de 15 MB por documento. Vale la foto hecha con el móvil, el escaneo y el PDF que manda el proveedor.
La precisión media de lectura y clasificación de Dijit es del 99% sobre PDF original. En documentos fotografiados depende de la calidad de la imagen: es el factor que más influye en cuánto hay que corregir después.
Sí. Varias fotos se agrupan como un solo documento, y se procesa entero, no por partes.
No. La IA interpreta un documento que no ha visto nunca, sin plantilla previa, y sigue funcionando cuando el proveedor cambia el diseño.
Sí. Al entrar desde una pantalla estrecha la aplicación lleva a un acceso rápido con lo único que hace falta ahí: elegir el tipo de documento y subir la foto.
En servidores Microsoft Azure dentro de la Unión Europea, con cifrado TLS 1.3 y acceso por roles. Los documentos de los clientes no se usan para entrenar modelos. Más en seguridad y cumplimiento.
La prueba es gratuita: 14 días y 20 documentos, sin coste y sin permanencia. Hay más respuestas en las preguntas frecuentes.
14 días y 20 documentos. Sin tarjeta, sin permanencia y sin instalar nada.
¿Prefieres verlo con tus documentos delante? Pide una demo.